L'IA Générative bouscule nos certitudes. Elle fascine, effraie, mais surtout, nous renvoie à notre propre image. Ni gourou techno-béat, ni prophète de malheur, je collectionne ces traits communs surprenants, ces instants où la frontière entre la machine et nous s'efface.
Il ne suffit pas d'ânonner sans comprendre que « les LLM sont des modèles statistiques qui prédisent le prochain mot » pour saisir ce qui se passe quand on regarde ChatGPT dérouler sa prose, comme un enfant admire émerveillé un petit train électrique qui tourne sans relâche.
Chaque fois que je cite cette « définition », ou que quelqu'un d'autre la cite, je suis frappé de voir tout le monde acquiescer. Personnellement, j'ai eu du mal à l'avaler. Allez-y... Essayez donc de prédire le « prochain mot » en vous basant uniquement sur la distribution de fréquence conditionnelle des mots. Franchement, vous (...)
(...)
Alors ? Vous avez complété ce paragraphe à ma place ? Vous avez sans doute deviné quelque chose comme « Franchement, vous pensez ». Puis « vous pensez que »... Et ensuite ?
Allons. Comment diable arrive-t-on aux réponses longues et impeccables d'un Claude ou d'un ChatGPT bien prompté ? Mon intuition première, c'est que le résultat le plus probable devrait être du charabia intégral. Mais nous y reviendrons.
Pour l'instant, parlons de Mamie.
Le modèle de langage originel
Vous la connaissez. Cette aïeule qu'il fallait bien inviter au mariage. Son mari commence à raconter l'achat de leur première maison ou sa rencontre avec le Président. Puis il s'interrompt. Pour ménager ses effets, ou simplement boire une gorgée de Château-Margaux.
Et tchac, Mamie prend la parole et finit sa phrase à sa place.
Voilà un modèle de langage que vous connaissez intimement : MamieGPT.
Pour fonctionner correctement, MamieGPT, comme tout LLM qui se respecte, a besoin :
- D'un large dataset d'entraînement (60 ans de mariage, soit pas mal d'EPOCHs en fait...)
- D'un contexte approprié (le début de l'histoire qui la met sur la voie)
- D'un prompt efficace (ces quelques secondes d'interruption, problème de paramétrage ?)
- D'un solide RLHF personnel (merci les bonnes sœurs du Couvent des Oiseaux pour les règles d'expression en société)
Remarquez les similitudes troublantes avec les modèles que les ingénieurs de la Silicon Valley nous vendent à prix d'or :
- Elle ne sait pas réellement ce que son mari allait dire
- Elle fait un pari, une prédiction
- Elle a souvent raison (mais ne dites jamais qu'elle « comprend » !)
- Les mots peuvent varier, le sens reste globalement le même
- Et oui, elle peut aussi se tromper magistralement !
Comment le langage fonctionne vraiment
Qu'est-ce qui rend cette prouesse possible ?
Wolfram s'est posé cette question* de manière très empirique, avec une expérience révélatrice, et a montré comment la force brute alliée aux mathématiques rend l'impossible possible.
Il a commencé au plus simple : prédire le mot suivant après « Le meilleur aspect de l'IA, c'est sa capacité à » en se basant uniquement sur des statistiques de fréquence. L'approche brute donne une liste classée, « apprendre » (15 %), « aider » (12 %), « traiter » (8 %), mais choisir systématiquement le mot en tête produit un texte plat et répétitif.
Il s'est alors demandé : d'où viennent ces probabilités ? Pouvait-il les reconstruire à partir de rien ?
Premier essai : les lettres. Il a analysé des échantillons de texte massifs, comptant la fréquence d'apparition de chaque lettre. Puis il a tenté de générer du texte en choisissant aléatoirement les lettres selon leurs fréquences. Résultat : « rsonthpeayofdkl... », du pur charabia. Même ajouter des espaces basés sur les longueurs de mots typiques n'aidait guère : « rsont hpea yofd kl... », toujours incompréhensible.
Deuxième essai : les bigrammes (paires de lettres). Maintenant « th » mène généralement à « e », « qu » à « u ». Le résultat s'améliore : « Weetollbever firsapres... ». On devine presque des motifs ressemblant à des mots, mais c'est encore du non-sens.
Troisième essai : les trigrammes. Encore mieux. Quelques vrais mots anglais commencent à apparaître dans cette soupe aléatoire. Avec les 4-grammes, des fragments de vrai langage émergent.
Le motif était clair : plus le contexte est long, plus le texte devient sensé. Wolfram est alors passé aux mots entiers au lieu des lettres, en appliquant la même logique. Fréquences de mots isolés : chaos. Combinaisons de 2 mots (bigrammes) : « chat » suit souvent « le », créant des fragments réalistes. Combinaisons de 3 mots : soudain, vous obtenez des phrases cohérentes comme « le chat était » ou « était sur le ».
La conclusion ? Avec suffisamment de force brute computationnelle pour compter ces motifs sur des milliards d'exemples de texte, plus des techniques mathématiques pour lisser les statistiques, vous pouvez effectivement faire de la rétro-ingénierie sur les règles qui font fonctionner le langage. Ce qui semblait de la pure magie, prédire le mot suivant, devient un problème d'ingénierie soluble.
Comme le dit Stephen Wolfram, « nous avons réussi l'IA Générative parce que maîtriser le langage s'est révélé plus facile que nous le craignions ». Une façon provocante de souligner la dimensionnalité étonnamment faible du langage humain. Nous utilisons typiquement environ 20 à 35 000 mots dans la vie quotidienne (en excluant les points aberrants, comme par exemple certains présidents américains). Ainsi, dans un espace à n dimensions, avec un n suffisamment grand, fabriquer une machine qui parle n'est pas si farfelu.
Nous avons réussi l'IA Générative parce que maîtriser le langage s'est révélé plus facile que nous le craignions.
S. Wolfram
La Machine de Laputa : le ChatGPT de 1726
Ces machines qui parlent, Swift les avait imaginées dès 1726 dans Les Voyages de Gulliver (chapitre Laputa). Sa « Machine » était un dispositif mécanique couvert de mots qui, actionné par des étudiants, les recombinait aléatoirement pour produire de la « connaissance philosophique ». Swift voulait se moquer de la grandiloquence de la Royal Society et de sa foi dans le raisonnement mécanique. La plaisanterie : produire un discours apparemment profond par pure combinaison mécanique, sans compréhension ni intelligence (idée reprise dans les années 2000 par les populaires Bingo du Bullshit).
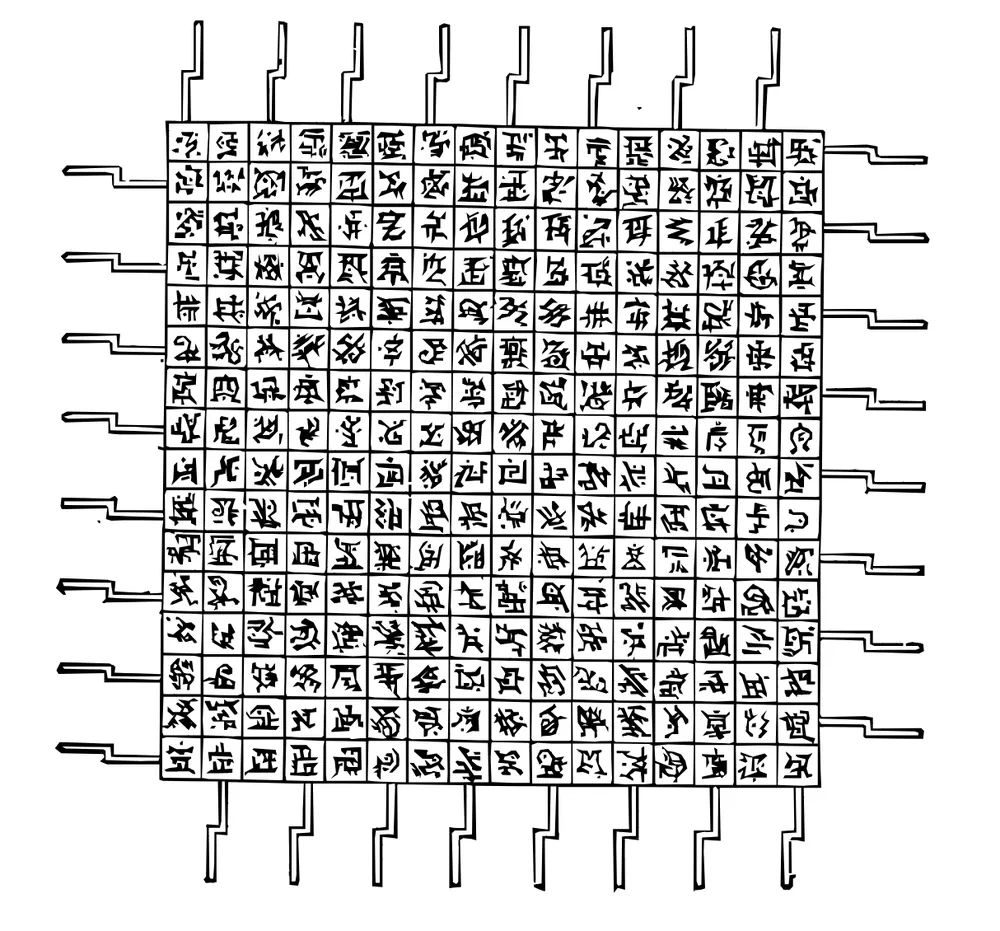
L'ironie est savoureuse : la satire de Swift est devenue notre réalité technologique. Sa Machine imaginaire fonctionnait exactement selon le principe qui anime nos modèles de langage actuels, la recombinaison systématique d'éléments linguistiques existants pour produire du texte nouveau et cohérent. Là où Swift voyait l'absurdité, nous avons découvert une vérité computationnelle profonde. L'approche mécanique des Laputiens n'était pas une folie, c'était une prophétie.
Plus frappant encore : Swift avait intuité que le langage possède une structure combinatoire sous-jacente exploitable mécaniquement. Trois siècles avant les expériences de Wolfram avec les n-grammes, avant les réseaux de neurones, avant que quiconque comprenne la linguistique statistique, Swift avait saisi qu'un discours sensé pourrait émerger de la recombinaison systématique de composants linguistiques. Sa Machine préfigure non seulement l'architecture de ChatGPT, mais son intuition fondamentale : le langage, malgré son apparente créativité infinie, suit des motifs suffisamment mécaniques pour être capturés et reproduits.
Ce que Swift raillait comme le comble de la stérilité intellectuelle, nous le reconnaissons aujourd'hui comme le fondement de l'intelligence artificielle. Les machines parlantes sont là, et elles fonctionnent exactement comme il l'avait imaginé, juste sans la satire.
Une raison d'être moins prévisible
La possibilité mathématique que Wolfram démythifie, un langage dont on peut faire la rétro-ingénierie par la force brute computationnelle et les motifs statistiques, converge magnifiquement avec l'intuition satirique, vieille de trois siècles, de Swift sur la génération mécanique de texte. Mais plus révélateur encore, cela s'aligne avec ce que nous vivons quotidiennement : finir les phrases des autres, prédire les réponses, être rarement véritablement surpris par ce qu'on nous dit.
Ces trois perspectives, calcul rigoureux, imagination littéraire et expérience vécue, pointent vers la même vérité sous-jacente. Le langage n'est pas cette force mystique et infiniment créative qu'on imaginait. Il suit des motifs identifiables, obéit à des régularités statistiques, opère dans des limites prévisibles. Ce qu'on prenait pour de la magie n'était que de la complexité qu'on n'avait pas encore appris à mesurer.
Le langage n'est pas cette force mystique et infiniment créative que nous imaginions tous
C'est peut-être un peu déprimant, que des machines puissent si bien imiter notre faculté la plus humaine. C'est sans doute même dangereux : tout ce potentiel de confusion, de manipulation, de persuasion artificielle. Je vois cela différemment. Comprendre comment ces systèmes fonctionnent, reconnaître les motifs qu'ils exploitent, nous donne les armes pour interagir avec eux consciemment plutôt que de subir leur influence sans le savoir. Nous pouvons nous en servir délibérément, avec scepticisme, avec stratégie.
Et personnellement ? Cela me motive à être moins prévisible. Si mon langage suit des motifs statistiques que les machines peuvent apprendre, alors il est peut-être temps de me surprendre, et de surprendre tout le monde, un peu plus souvent.
Humains, LLM : sous le capot, l'étonnante parenté.
(*) Pour les curieux, Stephen Wolfram détaille cette expérience dans son article de 2023 : « What Is ChatGPT Doing... and Why Does It Work? »